Datenbasiertes Feedback zu Auftritt, Stimme & Sprache.
Laden Sie ein beliebiges Video hoch; in wenigen Minuten bekommen Sie eine ausführliche Auswertung: Körpersprache, Mimik, Stimmqualität und Sprachfluss, strukturiert und vergleichbar. Auch parallel zu einem Gespräch in der Dialogsimulation.
Annotiertes Video: Skelett-Overlay, Hand-Trails und Blickrichtung.
Vier Ebenen, ein Rhetorik-Score.
Körpersprache & Gestik
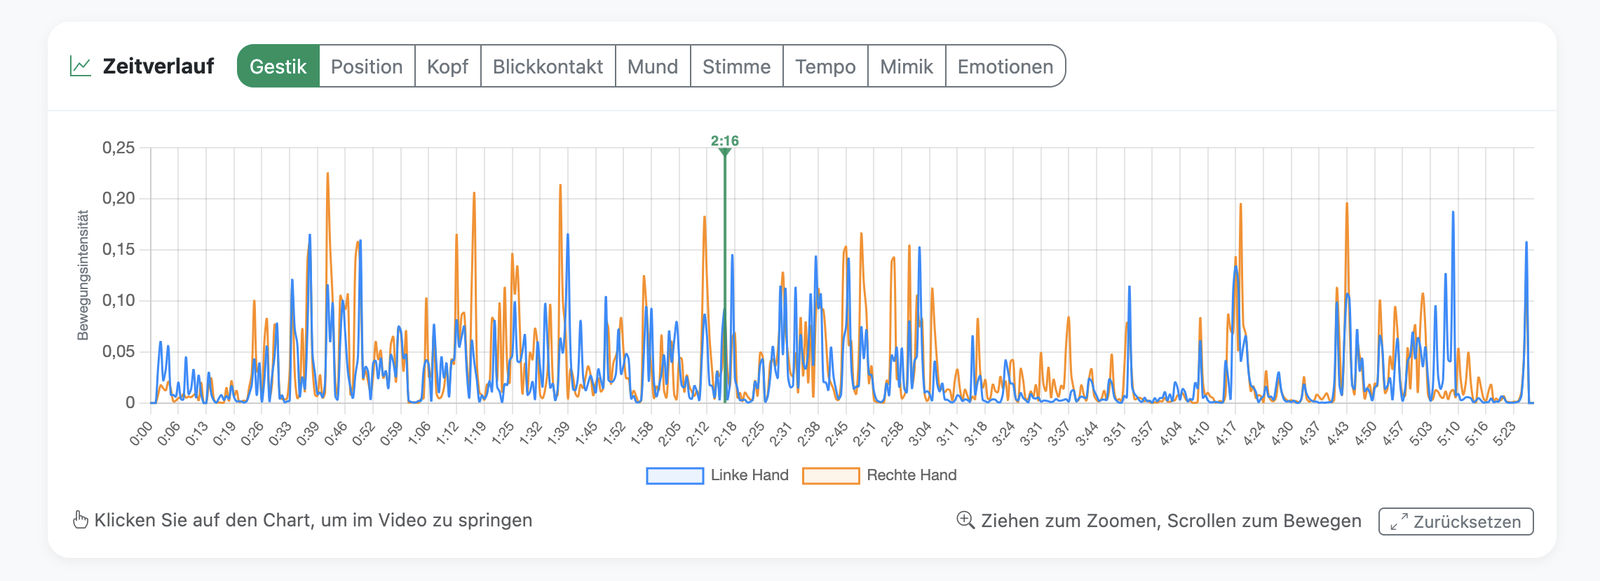
Skelett-Tracking, Gestik-Aktivität, Oberkörper-Stabilität, Armhaltung.
Mimik & Blickkontakt
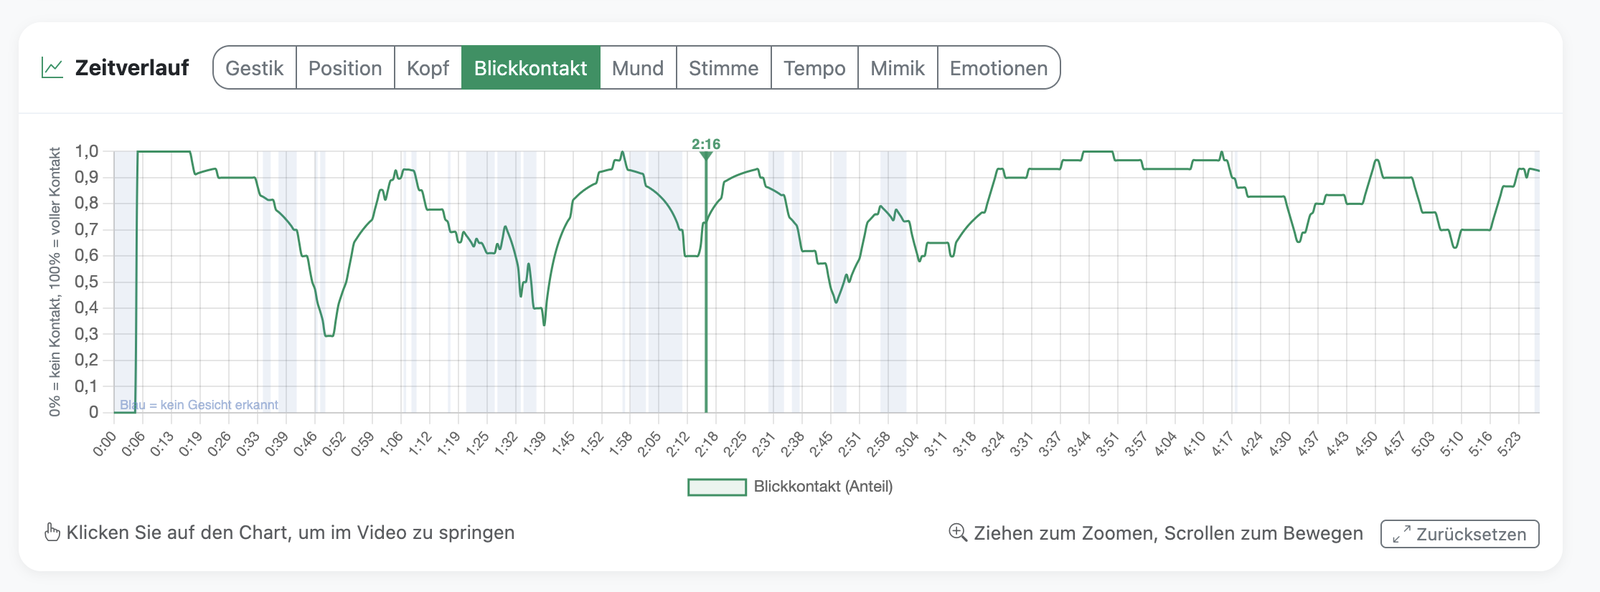
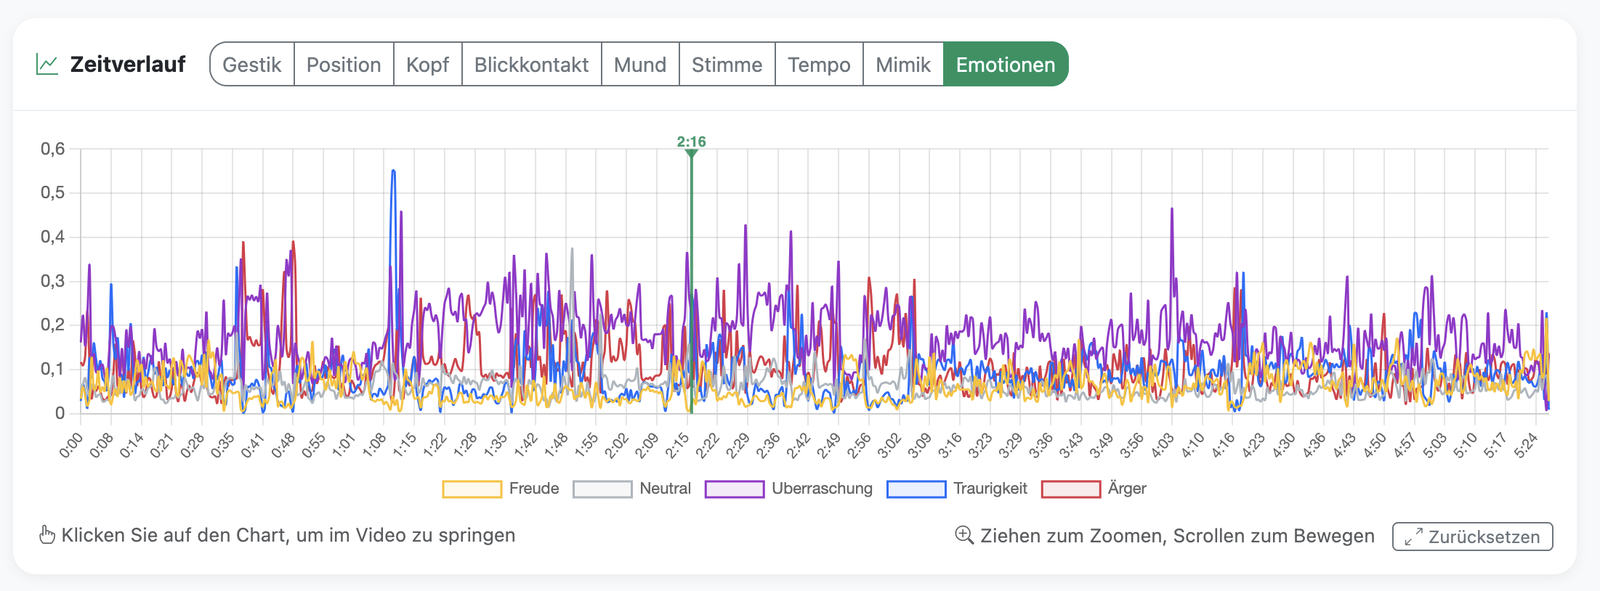
Kopfhaltung, Blickkontakt-%, Action Units (FACS), optionale Emotionserkennung (als Näherung, mit EU-AI-Act-Hinweis).
Stimme
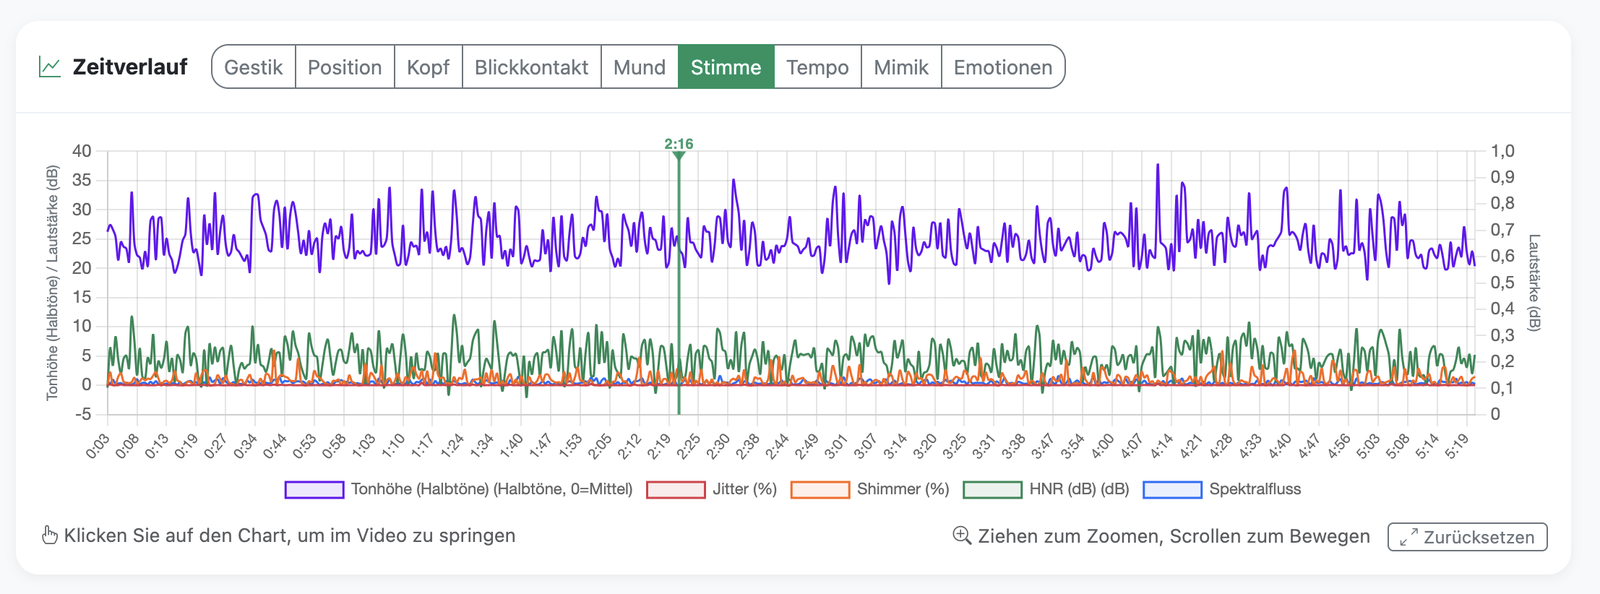
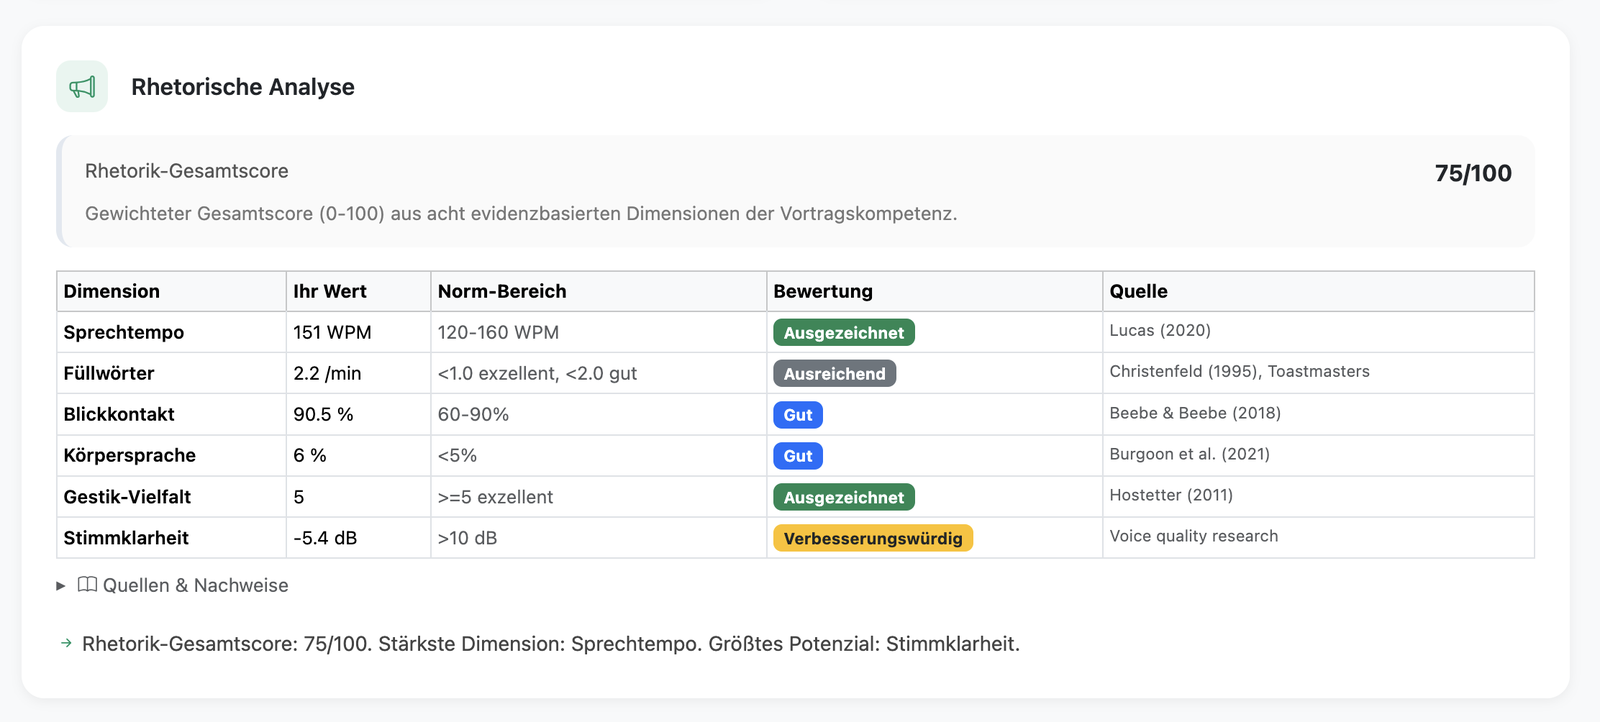
Tonhöhe, Modulation, Lautstärke, Stimmklarheit (HNR), Jitter/Shimmer.
Sprache
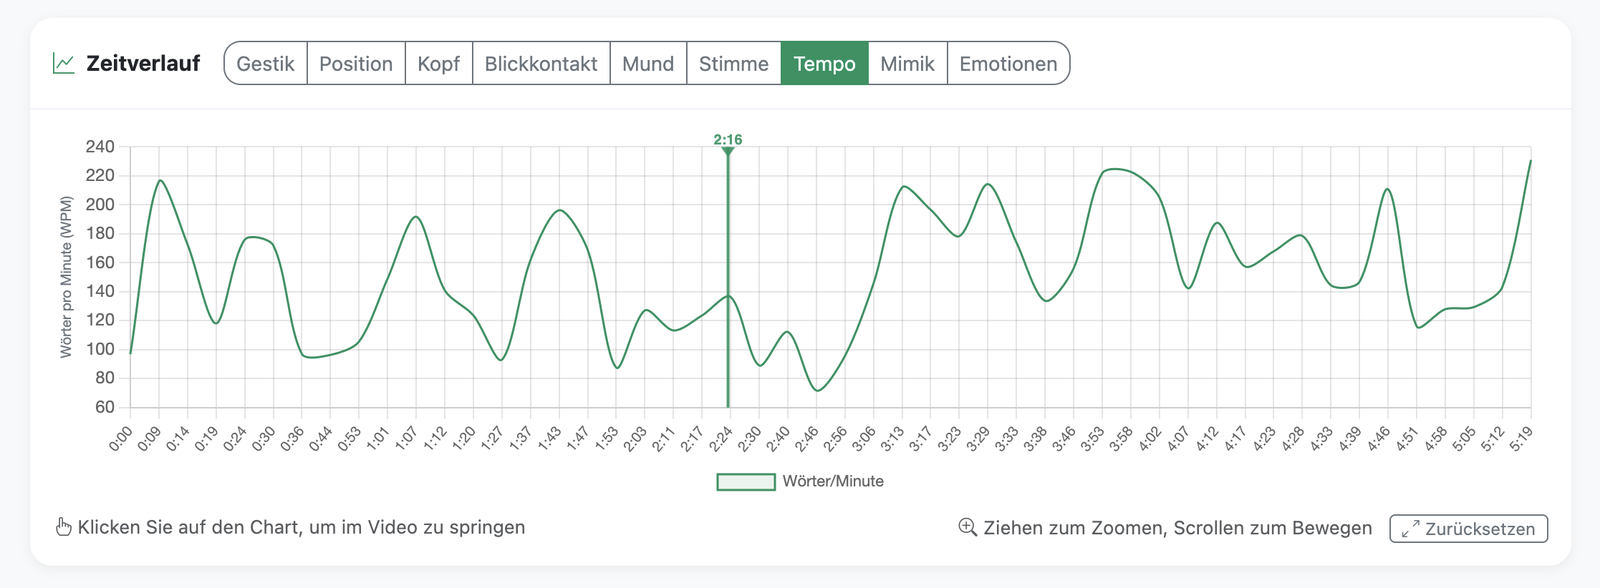
Transkript mit Zeitstempeln, Sprechtempo (WPM), Pausen, Füllwörter.
Jede Metrik als Zeitverlauf; anklicken zum Vergrößern.
Auswertung in Deutschland; kein Video verlässt die EU.
Der Upload läuft über unseren Server bei Hetzner in der EU (Finnland). Die rechenintensive Auswertung erfolgt auf einem dedizierten GPU-Server in Deutschland (IONOS, Rechenzentrum Frankfurt am Main). Alle Analyse-Modelle arbeiten lokal auf diesem Server; Video und Bilder bleiben in der EU, und niemand außer Ihnen sieht die Aufnahme. Details in der Datenschutzerklärung →
In drei Schritten
Video hochladen
Ein beliebiges Präsentations- oder Gesprächsvideo, auch parallele Aufzeichnungen aus der Dialogsimulation.
Automatische Analyse in Deutschland
Zehn Analyse-Module laufen parallel mit lokalen Modellen auf dem deutschen GPU-Server; das Rohvideo wird danach sofort gelöscht.
Strukturiertes Feedback
In wenigen Minuten: Dashboard mit annotiertem Video, Charts, Rhetorik-Score, Benchmark und optionalem KI-Coaching, zugestellt per E-Mail-Link.
Jetzt nutzbar, datenschutzkonform in Deutschland.
Video hochladen, in wenigen Minuten die umfangreiche Auswertung erhalten. Auswertung mit lokalen Modellen auf einem Server in Deutschland; kein Video und kein Bild verlässt die EU. Sprechen Sie uns an.